통계 계산기란?
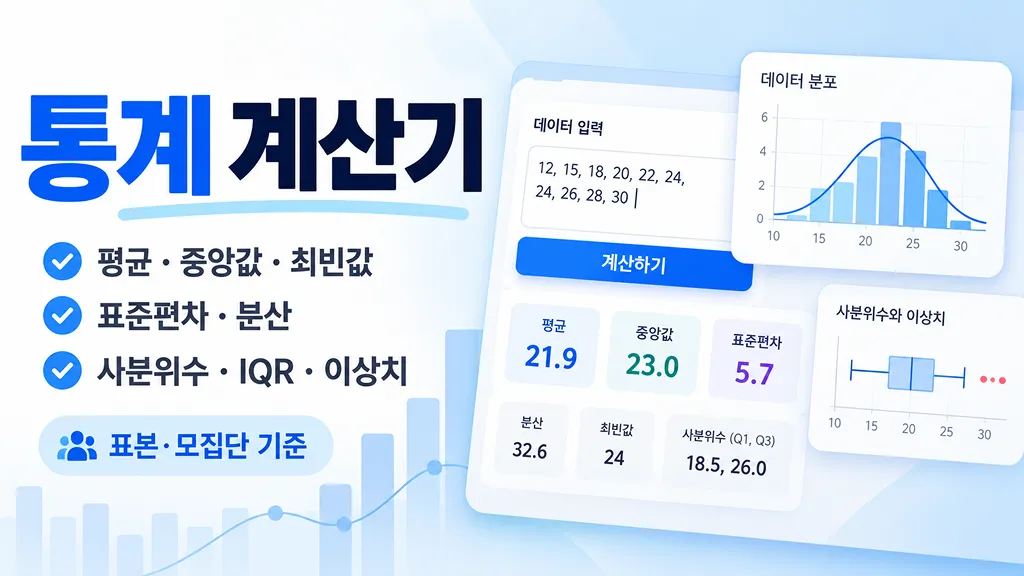
통계 계산기는 여러 숫자 데이터를 입력하면 평균, 중앙값, 최빈값, 분산, 표준편차 같은 기본 통계값부터 표준오차, 변동계수, 왜도, 첨도, 사분위수와 이상치까지 한 번에 계산해주는 기술통계 계산기입니다.
시험 점수, 설문조사 결과, 실험값, 측정 데이터, 매출, 가격, 운동 기록처럼 여러 숫자를 빠르게 분석해야 할 때 사용할 수 있습니다. 숫자를 직접 입력하거나 엑셀·스프레드시트의 숫자 목록을 복사해서 붙여넣으면 데이터의 중심과 퍼짐 정도, 분포의 특징을 함께 확인할 수 있습니다.
통계 계산기 사용 방법
분석할 숫자를 데이터 입력창에 붙여넣으면 자동으로 계산됩니다. 바로 결과를 보고 싶을 때는 [계산하기] 버튼을 누르세요. 쉼표, 공백, 줄바꿈으로 구분된 숫자를 입력할 수 있으며
1,000처럼 천 단위 쉼표가 포함된 숫자도 인식합니다.계산 결과는 기본 통계, 산포·오차, 분포 형태, 사분위·이상치로 나누어 확인할 수 있습니다. 모집단 분산과 표본 분산도 별도로 표시되므로 분석 목적에 맞는 값을 선택할 수 있습니다.
계산할 수 있는 통계값
이 통계 계산기에서는 다음과 같은 기술통계값을 계산합니다.
- 데이터 개수와 합계
- 평균(산술평균), 중앙값, 최빈값
- 기하평균과 조화평균
- 최솟값, 최댓값, 범위
- 모집단 분산과 수정 분산(표본 분산)
- 모집단 표준편차와 수정 표준편차(표본 표준편차)
- 표준오차(SEM)와 변동계수(CV)
- 평균절대편차와 중앙값절대편차(MAD)
- 왜도와 초과첨도
- Q1, Q2, Q3, IQR, 사분위편차
- 1.5 × IQR 기준 이상치
평균 계산 방법
평균(산술평균)은 모든 값을 더한 뒤 데이터 개수로 나눈 값입니다. 일반적인 평균 계산기에서 사용하는 가장 기본적인 평균입니다.
예를 들어, 10, 20, 30의 평균은 20입니다. 평균은 전체 데이터의 중심을 간단하게 나타낼 수 있지만, 매우 크거나 작은 이상치가 포함되면 값이 크게 달라질 수 있습니다.
평균·중앙값·최빈값의 차이
평균은 모든 값을 이용해 계산한 중심값이고, 중앙값은 데이터를 크기순으로 정렬했을 때 가운데에 위치하는 값입니다. 최빈값은 데이터에서 가장 자주 등장하는 값입니다.
예를 들어, 대부분의 값은 비슷하지만 하나의 값만 매우 큰 데이터에서는 평균이 크게 올라갈 수 있습니다. 이런 경우에는 평균뿐 아니라 중앙값과 사분위수를 함께 확인하면 데이터의 중심을 더 잘 이해할 수 있습니다.
기하평균 계산
기하평균은 성장률, 수익률 배수, 비율처럼 값이 곱셈적으로 누적되는 데이터를 비교할 때 사용할 수 있습니다.
실제 계산에서는 큰 숫자를 안정적으로 처리하기 위해 로그를 이용한 동일한 형태의 계산을 사용합니다. 현재 계산기에서는 모든 데이터가 0보다 큰 경우에만 기하평균을 표시합니다.
조화평균 계산
조화평균은 속도, 처리율, 단위당 비율처럼 값의 역수가 중요한 데이터를 평균낼 때 사용할 수 있습니다.
예를 들어, 같은 거리를 서로 다른 속도로 이동했을 때의 평균 속도를 구하는 상황에서 단순 산술평균보다 조화평균이 적절할 수 있습니다. 이 계산기에서는 0 이하의 값이 포함되면 조화평균을 계산하지 않습니다.
분산 계산과 수정 분산의 차이
분산은 각 데이터가 평균에서 얼마나 떨어져 있는지를 제곱한 뒤 평균하여 데이터의 퍼짐 정도를 나타내는 값입니다.
입력한 데이터 자체가 분석 대상 전체라면 모집단 분산을 사용할 수 있습니다.
더 큰 모집단에서 일부 데이터를 추출한 표본이라면 일반적으로 수정 분산 또는 표본 분산을 사용하며 분모를 로 계산합니다.
표준편차 계산
표준편차는 분산의 제곱근입니다. 분산과 달리 원래 데이터와 같은 단위를 사용하기 때문에 실제 데이터가 평균 주변에 어느 정도 퍼져 있는지 비교하기 쉽습니다.
이 계산기에서는 모집단 분산으로 계산한 모집단 표준편차와 수정 분산으로 계산한 수정 표준편차(표본 표준편차)를 모두 표시합니다.
표준오차(SEM) 계산
표준오차(Standard Error of the Mean, SEM)는 표본에서 계산한 평균이 표본을 다시 추출했을 때 어느 정도 달라질 수 있는지를 나타내는 지표입니다.
이 계산기에서는 수정 표준편차 를 사용해 다음과 같이 계산합니다.
데이터 수가 많아질수록 다른 조건이 같다면 표준오차는 작아지는 경향이 있습니다. 표준편차가 개별 데이터의 퍼짐을 나타내는 값이라면, 표준오차는 표본평균의 불확실성과 관련된 값이라는 차이가 있습니다.
변동계수(CV) 계산
변동계수(Coefficient of Variation, CV)는 표준편차가 평균에 비해 어느 정도 크기인지를 백분율로 나타냅니다. 평균 규모가 서로 다른 데이터의 상대적인 산포를 비교할 때 유용합니다.
현재 계산기는 수정 표준편차를 사용하며, 평균의 부호와 관계없이 상대적인 변동 크기를 보여주기 위해 평균의 절댓값을 분모로 사용합니다. 평균이 0이면 변동계수는 계산할 수 없습니다.
평균절대편차 계산
평균절대편차는 각각의 데이터가 평균에서 떨어진 거리의 절댓값을 구한 뒤 그 값을 평균한 것입니다.
분산처럼 편차를 제곱하지 않기 때문에 데이터의 평균적인 거리를 비교적 직관적인 형태로 확인할 수 있습니다.
중앙값절대편차(MAD) 계산
중앙값절대편차(Median Absolute Deviation, MAD)는 각 값과 중앙값의 거리를 구한 다음, 그 절대편차들의 중앙값을 계산한 것입니다.
중앙값을 기준으로 하기 때문에 매우 크거나 작은 이상치가 포함되어 있어도 표준편차보다 영향을 덜 받는 강건한 산포 지표로 사용할 수 있습니다.
왜도(비대칭도) 계산
왜도(Skewness)는 데이터 분포가 좌우로 얼마나 비대칭인지 나타냅니다. 왜도가 양수이면 일반적으로 큰 값 방향인 오른쪽 꼬리가 상대적으로 길고, 음수이면 작은 값 방향인 왼쪽 꼬리가 상대적으로 긴 형태입니다.
이 계산기에서는 작은 표본에서의 편향을 줄이기 위해 보정 Fisher-Pearson 표본 왜도를 사용합니다.
왜도는 데이터가 최소 3개 이상이고 분산이 0보다 큰 경우에 계산됩니다.
첨도와 초과첨도 계산
첨도(Kurtosis)는 데이터 분포의 꼬리 특성을 비교하는 데 사용하는 통계량입니다. 이 계산기에서는 일반 첨도에서 3을 뺀 초과첨도(Excess Kurtosis)를 표시합니다.
작은 표본의 편향을 보정하기 위해 다음 보정식을 적용합니다.
초과첨도 기준에서는 정규분포가 0입니다. 양수이면 정규분포와 비교해 상대적으로 꼬리가 두꺼운 편, 음수이면 상대적으로 꼬리가 얇은 편으로 해석할 수 있습니다. 계산에는 최소 4개의 데이터가 필요합니다.
사분위수 Q1·Q2·Q3 계산
사분위수는 정렬한 데이터를 네 구간으로 나누는 기준값입니다. Q1은 25%, Q2는 50%, Q3는 75% 지점에 해당하며 Q2는 중앙값과 같습니다.
- Q1: 데이터의 25% 지점
- Q2: 데이터의 50% 지점, 중앙값
- Q3: 데이터의 75% 지점
사분위수는 정의가 여러 가지라 같은 데이터라도 프로그램마다 결과가 조금 다를 수 있습니다. 이 계산기는 기본값으로 선형 보간 방식(Excel
QUARTILE.INC, R 기본값)을 사용하며, 옵션에서 Excel EXC·Minitab·SPSS 방식이나 교과서에서 흔히 쓰는 Tukey 힌지 방식(절반의 중앙값)으로 바꿀 수 있습니다.IQR과 사분위편차 계산
IQR(Interquartile Range, 사분위범위)은 Q3에서 Q1을 뺀 값으로 데이터의 가운데 50%가 얼마나 넓게 퍼져 있는지 나타냅니다.
사분위편차는 IQR의 절반입니다.
이상치 계산 방법
이 통계 계산기는 일반적인 상자그림(Box Plot)에서 사용하는 1.5 × IQR 기준으로 이상치 후보를 찾습니다.
하한보다 작거나 상한보다 큰 값은 이상치 후보로 표시합니다. 이상치로 분류됐다고 해서 반드시 잘못 입력된 값이라는 의미는 아닙니다. 실제 분석에서는 측정 오류인지, 실제로 발생 가능한 극단값인지 데이터의 맥락을 함께 확인해야 합니다.
이상치 기준 바꾸기
기본값인 1.5 × IQR 외에도 극단 이상치만 찾는 3 × IQR, 평균과 표준편차를 쓰는 |Z| > 3, 중앙값과 MAD를 써서 이상치 자체의 영향을 덜 받는 수정 Z-score > 3.5 기준을 선택할 수 있습니다.
평균의 신뢰구간과 일표본 t-검정
추론 탭에서는 표본으로부터 모평균을 추정하는 신뢰구간을 90%, 95%, 99% 신뢰수준으로 계산합니다. 모표준편차를 모르는 일반적인 상황에 맞춰 t 분포를 사용합니다.
비교하고 싶은 모평균 를 입력하면 일표본 t-검정의 t 통계량과 p-값도 함께 확인할 수 있습니다.
정규성 검정
데이터가 정규분포를 따른다고 볼 수 있는지 확인하기 위해 왜도와 첨도를 이용한 Jarque–Bera 검정과 D'Agostino–Pearson K² 검정을 제공합니다. p-값이 유의수준보다 작으면 정규성 가정을 기각합니다. 검정 결과만으로 판단하기보다 히스토그램, Q-Q Plot과 함께 보는 것이 좋습니다.
도수분포표 만들기
도수분포표 탭에서는 계급 수, 계급의 크기, 시작값을 정해 계급·계급값·도수·상대도수·누적도수를 표로 만들 수 있습니다. 각 계급은 “이상 ~ 미만”으로 나누며 마지막 계급만 끝값을 포함합니다. 계급값과 도수로 구한 평균·분산도 함께 표시하므로 원자료로 구한 값과 비교해볼 수 있습니다.
풀이 과정 보기
풀이 탭에서는 평균, 편차와 편차 제곱, 분산, 표준편차, 중앙값, 사분위수를 구하는 과정을 실제 숫자를 대입한 식으로 보여줍니다. 데이터가 30개 이하일 때 모든 값을 대입해 표시합니다.
모집단 분산과 표본 분산 중 무엇을 사용해야 하나요?
분석하려는 대상의 모든 데이터를 가지고 있다면 모집단 분산과 모집단 표준편차를 사용할 수 있습니다. 반대로 더 큰 모집단의 특성을 추정하기 위해 일부 데이터만 수집한 경우에는 일반적으로 수정 분산과 수정 표준편차를 사용합니다.
요약 표에는 두 값이 모두 표시되어 직접 비교할 수 있습니다. 상단의 표본 / 모집단 기준을 바꾸면 변동계수, Z-score, 풀이 과정에 쓰이는 표준편차가 함께 바뀝니다.
통계 계산 결과를 해석할 때 주의할 점
하나의 통계값만으로 데이터 전체를 판단하기보다는 여러 지표를 함께 확인하는 것이 좋습니다. 평균이 같더라도 표준편차가 다르면 데이터의 퍼짐 정도가 다를 수 있고, 평균과 중앙값의 차이가 크다면 분포가 한쪽으로 치우쳐 있거나 이상치가 존재할 가능성을 살펴볼 수 있습니다.
또한 데이터 수가 매우 적을 때는 왜도, 첨도, 표준오차 등의 값이 데이터 몇 개의 변화에도 크게 달라질 수 있으므로 표본 크기와 데이터 수집 방법을 함께 고려해야 합니다.
자주 묻는 질문
- Q. 분산과 수정 분산의 차이는 무엇인가요?A. 모집단 분산은 편차 제곱합을 으로 나누고, 수정 분산은 로 나눕니다. 데이터 전체를 모집단으로 보는 경우에는 모집단 분산을, 더 큰 모집단에서 추출한 표본을 분석하는 경우에는 수정 분산을 주로 사용합니다.
- Q. 표준편차와 표준오차는 같은 값인가요?A. 아닙니다. 표준편차는 개별 데이터가 평균 주변에 얼마나 퍼져 있는지를 나타내고, 표준오차는 표본평균의 변동성을 나타냅니다. 이 계산기에서는 표준오차를 으로 계산합니다.
- Q. 숫자에 1,000처럼 쉼표가 있어도 되나요?A. 네, 엑셀 열처럼 줄마다 천 단위 쉼표가 들어간 숫자를 붙여넣으면 하나의 숫자로 인식합니다.
100,200,300처럼 천 단위로도, 세 개의 숫자로도 읽을 수 있는 입력은 어떻게 해석했는지 안내하고 직접 바꿀 수 있습니다. CSV·TXT 파일을 열거나 끌어다 놓아도 됩니다. - Q. 최빈값이 여러 개일 수도 있나요?A. 네, 가장 많이 등장한 횟수가 같은 숫자가 여러 개라면 해당 값을 모두 최빈값으로 표시합니다. 모든 숫자가 한 번씩만 등장하면 이 계산기에서는 최빈값이 없는 것으로 표시합니다.
- Q. 기하평균과 조화평균이 계산되지 않는 경우가 있나요?A. 네, 현재 계산기는 일반적인 양수 데이터의 기하평균과 조화평균을 계산합니다. 입력값에 0 또는 음수가 포함되어 있으면 기하평균과 조화평균을 계산 불가로 표시합니다.
- Q. 왜도와 첨도가 계산되지 않는 경우가 있나요?A. 네, 보정 왜도는 최소 3개의 데이터가 필요하고, 보정 초과첨도는 최소 4개의 데이터가 필요합니다. 또한 모든 값이 같아 분산이 0인 경우에도 왜도와 첨도를 계산할 수 없습니다.
- Q. 이상치는 자동으로 제외되나요?A. 아닙니다. 평균, 분산, 표준편차 등 기본 통계 계산에는 입력한 모든 데이터가 포함됩니다. IQR 기준 이상치가 발견된 경우에는 비교를 위해 이상치 제외 평균을 별도로 표시합니다.
- Q. 모집단 표준편차와 수정 표준편차 중 어떤 값을 봐야 하나요?A. 입력한 데이터가 분석 대상 전체라면 모집단 표준편차를 볼 수 있습니다. 더 큰 모집단에서 일부를 추출한 표본이라면 수정 표준편차를 주로 사용합니다. 이 계산기에서는 두 값을 모두 표시해 비교할 수 있습니다.
- Q. 평균과 중앙값 중 어떤 값을 보는 것이 좋나요?A. 데이터가 비교적 고르게 분포되어 있다면 평균이 대표값으로 유용합니다. 반대로 매우 크거나 작은 값이 포함되어 있다면 평균이 크게 영향을 받을 수 있으므로 중앙값과 사분위수도 함께 확인하는 것이 좋습니다.
- Q. IQR로 표시된 이상치는 반드시 잘못된 데이터인가요?A. 아닙니다. 1.5 × IQR 기준은 이상치 후보를 찾기 위한 통계적인 기준입니다. 실제로는 정상적으로 발생할 수 있는 극단값일 수도 있으므로, 측정 오류 여부와 데이터가 만들어진 상황을 함께 확인해야 합니다.