분산 계산기란?
분산 계산기는 여러 숫자가 평균을 중심으로 얼마나 퍼져 있는지를 계산하는 도구입니다. 평균이 데이터의 중심을 나타낸다면, 분산은 데이터가 그 중심에서 얼마나 떨어져 있는지를 나타냅니다. 값들이 평균 근처에 모여 있으면 분산이 작고, 평균에서 멀리 떨어진 값이 많으면 분산이 커집니다.
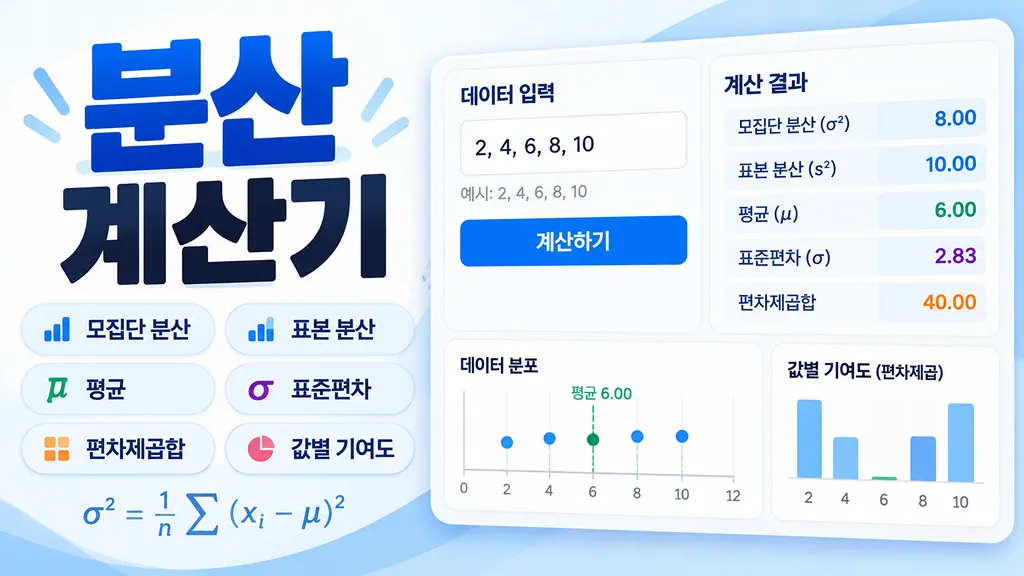
이 계산기는 분산 자체에 초점을 맞춰 모집단 분산, 표본 분산, 평균, 표준편차, 데이터 분포, 값별 분산 기여도를 함께 보여줍니다. 특히 데이터가 많을 때는 분포 그래프로 전체적인 퍼짐을 확인하고, 분산 기여도 표에서 평균에서 멀리 떨어져 분산을 크게 만드는 값을 확인할 수 있습니다.
분산 공식
모집단 전체를 분석할 때 사용하는 모집단 분산 공식은 다음과 같습니다.
는 각 데이터 값, 는 모집단 평균,은 모집단 데이터 개수입니다.
모집단 전체가 아니라 일부 표본으로 모집단의 변동성을 추정할 때는 일반적으로 표본 분산을 사용합니다.
는 표본 평균, 은 표본 개수입니다. 표본 분산은 분모로 을 사용합니다.
편차제곱합과 분산의 관계
분산을 이해할 때 핵심은 편차제곱합(Sum of Squares, SS)입니다. 먼저 각 값에서 평균을 빼 편차를 구하고, 편차를 제곱한 값을 모두 더합니다.
모집단 분산은 이 편차제곱합을 으로 나누고, 표본 분산은 로 나눕니다. 즉 분산은 데이터가 평균에서 떨어진 제곱 거리의 평균으로 이해할 수 있습니다.
왜 편차를 제곱해서 분산을 구하나요?
평균보다 작은 값의 편차는 음수이고 평균보다 큰 값의 편차는 양수입니다. 편차를 그대로 모두 더하면 양수와 음수가 상쇄되어 0이 됩니다. 따라서 분산에서는 편차를 제곱해 모두 0 이상으로 만든 뒤 합산합니다.
제곱에는 또 하나의 특징이 있습니다. 평균에서 두 배 멀어진 값은 편차제곱이 네 배가 됩니다. 그래서 평균에서 크게 벗어난 데이터가 분산에 더 큰 영향을 줍니다. 이 계산기의 분산 기여도 표를 보면 그 차이를 직접 확인할 수 있습니다.
모집단 분산과 표본 분산의 차이
분석하려는 대상의 모든 데이터를 가지고 있다면 모집단 분산을 사용합니다. 예를 들어, 한 학급 학생 전체의 시험 점수 자체를 분석한다면 그 학급 점수는 모집단으로 볼 수 있습니다.
반대로 전체 고객, 전체 제품, 전체 실험 결과 중 일부만 추출해 전체의 변동성을 추정한다면 표본 분산을 사용하는 것이 일반적입니다. 표본 평균을 계산하는 과정에서 자유도 하나를 사용하기 때문에 표본 분산은 대신 로 나누는 형태를 사용합니다.
분산 계산 예시
데이터가
2, 4, 6, 8, 10이라고 해보겠습니다. 평균은 6입니다.같은 숫자라도 모집단으로 보는지 표본으로 보는지에 따라 분산이 8 또는 10으로 달라집니다.
분산과 표준편차의 관계
표준편차는 분산의 제곱근입니다.
분산은 원래 단위의 제곱 단위를 사용합니다. 예를 들어, 키를 cm로 측정했다면 분산의 단위는 cm²입니다. 표준편차는 제곱근을 취하므로 다시 cm처럼 원래 데이터와 같은 단위가 되어 해석이 더 직관적입니다. 반면 통계 모델과 분산분석에서는 분산 자체가 직접 사용되는 경우가 많습니다.
분산이 크면 무조건 데이터가 나쁜가요?
아닙니다. 분산은 좋고 나쁨을 판정하는 점수가 아니라 퍼짐 정도를 나타내는 값입니다. 어떤 분산이 큰지 작은지는 데이터의 단위, 평균 수준, 비교 대상과 함께 해석해야 합니다. 서로 단위가 다른 데이터의 분산을 숫자 크기만으로 직접 비교하는 것은 적절하지 않습니다.
이상치가 분산에 큰 영향을 주는 이유
분산은 편차를 제곱하므로 평균에서 크게 벗어난 값에 민감합니다. 예를 들어, 대부분의 값이 10 근처인데 하나의 값만 100이라면 그 값의 편차제곱이 매우 커져 전체 분산도 크게 증가할 수 있습니다. 그래서 분산을 볼 때는 숫자 하나만 확인하기보다 데이터 분포와 분산 기여도를 함께 확인하는 것이 좋습니다.
분산의 역사: 왜 분산이라는 개념이 필요했나요?
분산의 역사는 단순히 새로운 공식을 하나 만든 이야기라기보다, 서로 다른 원인으로 생긴 변동을 어떻게 나누어 설명할 것인가라는 문제에서 시작됩니다. 19세기 말 생물측정학에서는 사람의 키처럼 연속적으로 달라지는 특성을 평균, 표준편차, 상관관계로 분석하고 있었습니다. 그런데 20세기 초 멘델 유전법칙이 다시 주목받으면서 한 가지 큰 문제가 생겼습니다. 멘델의 유전 요인은 서로 구분되는 형태로 전달되는데, 실제 사람의 키와 같은 특성은 왜 종 모양에 가까운 연속적인 분포를 보이는가 하는 문제였습니다.
R. A. Fisher는 1918년 논문 The Correlation between Relatives on the Supposition of Mendelian Inheritance에서 이 둘이 서로 모순되지 않는다는 것을 설명하려 했습니다. 여러 유전 요인이 함께 작용해 하나의 측정값을 만든다고 생각하면, 전체 변동 중 어느 정도가 각각의 원인에서 왔는지를 나누어 계산할 수 있어야 했습니다. 하지만 표준편차는 서로 독립적인 변동 원인의 크기를 단순히 더해서 전체 변동을 설명하기에 적합하지 않았습니다.
Fisher가 주목한 것은 표준편차의 제곱이었습니다. 서로 독립적인 변동 원인이 함께 작용할 때는 표준편차 자체가 아니라 그 제곱을 이용하면 전체 변동을 각 원인이 만든 변동으로 나누어 다룰 수 있습니다. Fisher는 논문에서 이 값을 Variance라고 부르고, 전체 variance 중 각 원인이 차지하는 몫을 비율이나 퍼센트로 설명할 수 있다고 제시했습니다. 즉 분산은 단순히 데이터가 얼마나 흩어졌는지 재기 위한 값이 아니라, 관측된 차이가 어디에서 생겼는지를 나누어 설명하기 위한 도구로 중요해졌습니다.
이 접근을 이용하면 여러 개의 멘델식 유전 요인이 조금씩 영향을 줄 때 키처럼 연속적으로 보이는 특성도 나타날 수 있고, 친족 사이의 유사성도 같은 틀에서 분석할 수 있었습니다. Fisher는 변동을 가산적인 유전 효과와 우성 효과 등으로 나누어 다루면서 당시 서로 충돌하는 것으로 보였던 생물측정학과 멘델 유전학을 연결했습니다. 제곱편차 자체는 Fisher 이전에도 사용되었지만, 분산이라는 이름과 함께 전체 변동을 원인별 성분으로 나누는 사고방식을 분명하게 만든 것이 중요한 변화였습니다.
이 생각은 곧 실제 실험 문제로 이어졌습니다. Fisher가 1919년 영국 Rothamsted Experimental Station에서 농업 실험 데이터를 다루기 시작했을 때는 작물 수확량의 차이가 비료나 품종 때문인지, 토양 차이와 우연한 실험 오차 때문인지 구분해야 했습니다. Fisher는 전체 변동을 원인별로 나누어 비교하는 방법을 발전시켰고, 1923년에는 현대적인 형태의 분산분석(ANOVA) 표가 포함된 연구가 발표되었습니다. 이후 분산은 유전학뿐 아니라 농업 실험, 의학, 심리학, 품질관리 등에서 여러 원인이 결과의 변동에 얼마나 기여했는지를 분석하는 핵심 개념으로 자리 잡았습니다.
분산 계산기 사용 방법
숫자를 쉼표, 공백 또는 줄바꿈으로 구분해 입력하고 모집단 분산 또는 표본 분산을 선택한 뒤 [계산하기]를 누르세요. 엑셀이나 스프레드시트의 숫자 열을 그대로 붙여넣어도 됩니다.
결과에서는 분산과 표준편차를 먼저 확인한 뒤, 데이터 분포 → 분산에 크게 기여한 값 순서로 보면 데이터가 얼마나 퍼져 있고 어떤 값이 그 퍼짐을 크게 만드는지 더 쉽게 이해할 수 있습니다.
분산 계산 시 주의할 점
- 표본 분산은 데이터가 최소 2개 필요합니다.
- 분산은 항상 0 이상이며 음수가 될 수 없습니다.
- 모든 값이 같으면 모든 편차가 0이므로 분산도 0입니다.
- 평균에서 매우 멀리 떨어진 값은 제곱 과정 때문에 분산에 큰 영향을 줍니다.
- 서로 다른 단위의 값을 섞어 하나의 분산으로 계산하면 해석하기 어렵습니다.
- 분산 값의 크기만으로 좋고 나쁨을 판단하지 말고 비교 기준과 데이터 분포를 함께 확인하세요.
자주 묻는 질문
- Q. 분산은 음수가 될 수 있나요?A. 아니요. 각 편차를 제곱한 뒤 계산하기 때문에 분산은 항상 0 이상입니다.
- Q. 분산이 0이라는 것은 무슨 뜻인가요?A. 모든 데이터 값이 서로 같다는 뜻입니다. 모든 값이 평균과 같기 때문에 편차와 편차제곱이 모두 0이 됩니다.
- Q. 표본 분산이 모집단 분산보다 큰 이유는 무엇인가요?A. 같은 데이터에서는 모집단 분산은 으로 나누고, 표본 분산은 로 나누기 때문입니다. 표본으로 모집단 분산을 추정할 때 생기는 편향을 보정하기 위해 사용하는 방식입니다.
- Q. 분산과 표준편차는 같은 것인가요?A. 아닙니다. 표준편차는 분산의 제곱근입니다. 둘 다 데이터의 퍼짐을 나타내지만 단위와 활용 방식이 다릅니다.
- Q. 어떤 값이 분산을 가장 크게 만드는지 알 수 있나요?A. 네, 이 계산기의 분산 기여도 표에서 평균에서 멀리 떨어져 편차제곱이 큰 값을 확인할 수 있습니다.
참고 자료
분산과 표본 분산 공식은 NIST Engineering Statistics Handbook을 참고했습니다. 분산의 역사 부분은 Fisher의 1918년 원 논문과 Rothamsted의 실험설계·분산분석 역사 자료를 참고했습니다. NIST Measures of Scale · NIST Sample Variance · Fisher (1918) · Rothamsted · Fisher와 분산분석의 발전