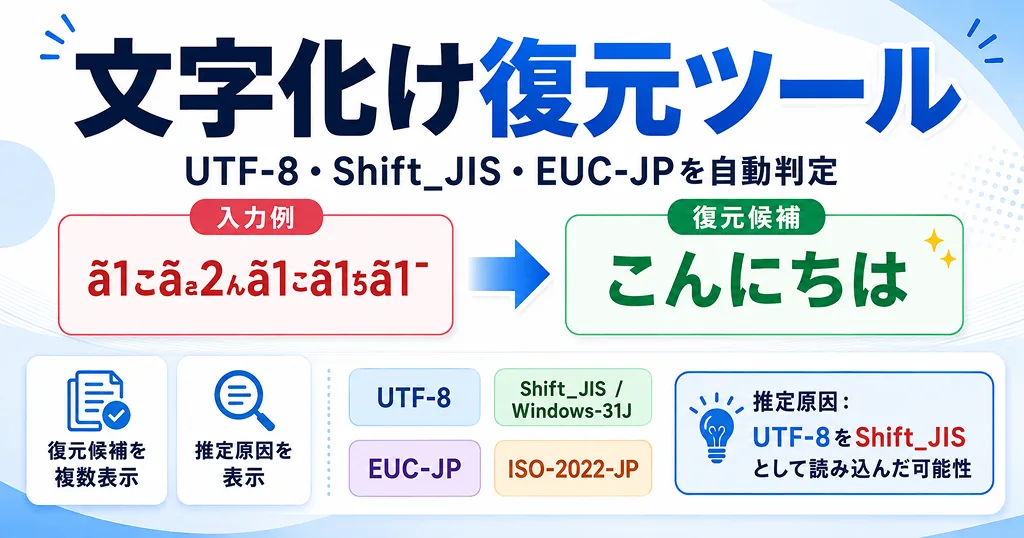
文字化けした日本語を貼り付けると、UTF-8・Shift_JIS / Windows-31J・EUC-JP・ISO-2022-JPなどの 読み違いを試し、復元候補と推定原因をまとめて表示します。
文字列を復元
TXT・CSVを判定
文字化け復元ツールとは?
文字化け復元ツールは、本来の文字コードと異なる方式でテキストを読み込んだために 「縺薙s縺ォ縺。縺ッ」や「ããã«ã¡ã¯」のようになった文字列から、 元の日本語を推定して復元候補を表示するツールです。
一般的な文字コード変換ツールは「元の文字コード」と「変換先」を自分で選ぶ必要があります。 このページでは複数の読み違いパターンを自動で試し、読みやすい日本語になった候補を優先表示します。 そのため、原因の文字コードがわからない場合でも使いやすい構成にしています。
対応している主な文字コード
- UTF-8:現在のWebサイトや多くのアプリで広く使われるUnicode系の文字コード
- Shift_JIS / Windows-31J:WindowsのCSVや古い業務システムなどで見かけることが多い日本語系文字コード
- EUC-JP:旧来のUNIX系システムや古いWebコンテンツなどで使われてきた日本語文字コード
- ISO-2022-JP:古い日本語メールなどで使われることがある文字コード
- ISO-8859-1 / Windows-1252系:UTF-8のバイト列を1バイト文字として誤読したときの復元経路として利用
「ããã«ã¡ã¯」が「こんにちは」に戻る理由
「こんにちは」をUTF-8で保存すると、日本語1文字が複数バイトの並びになります。 そのバイト列をLatin-1系の1バイト文字として誤って文字列化すると、 「ã」や制御文字を含む崩れた表示になることがあります。
このツールでは逆方向に、文字化け後の文字から誤読時のバイト列をできるだけ再現し、 そのバイト列をUTF-8・Shift_JIS・EUC-JP・ISO-2022-JPとして読み直して候補を作ります。
「縺薙s縺ォ縺。縺ッ」のような文字化け
UTF-8の日本語をShift_JIS / Windows-31Jとして誤って読み込むと、 「縺」「繧」などを含む日本語らしい見た目の文字化けになる場合があります。 見た目に漢字やカタカナが含まれていても、文章として不自然なら文字コードの読み違いを疑う価値があります。
CSVの文字化けを直すときのポイント
Excel、基幹システム、EC管理画面、顧客管理ツールなどから出力したCSVでは、 保存側と読み込み側の文字コードが一致していないと文字化けすることがあります。 元のCSVファイルが残っている場合は、コピー後の文字列よりもファイルそのものを判定する方が復元しやすいため、 上部の「TXT・CSVを判定」を利用してください。
完全に復元できないケース
- すでに「�」へ置換され、元のバイト情報が失われている場合
- 文字化けした状態で再保存され、複数回の変換が重なっている場合
- 機種依存文字・外字・ベンダー独自拡張が含まれている場合
- 文字コードではなく、フォント不足やUnicode正規化など別の原因で表示が崩れている場合
よくある質問
- Q. 自動判定で必ず元の文章に戻せますか?A. 必ず戻せるわけではありません。文字化けの過程で元のバイトが失われている場合や、複数回の誤変換が行われている場合は完全復元できないことがあります。そのため、このツールでは1つの答えに断定せず複数候補を表示します。
- Q. Shift_JISとWindows-31Jは別々に判定しないのですか?A. WebのEncoding Standardでは「windows-31j」はShift_JISのラベルとして扱われます。このツールでも実用上わかりやすいよう「Shift_JIS / Windows-31J」とまとめて表示しています。
- Q. メールの文字化けにも使えますか?A. 本文をコピーできる場合は試せます。特に古い日本語メールではISO-2022-JPが使われることがあります。ただしMIMEヘッダーやBase64・Quoted-Printableの問題が原因の場合は、先にメールの転送エンコードを解除する必要があります。