UTF-8 EUC-KR 변환기란?
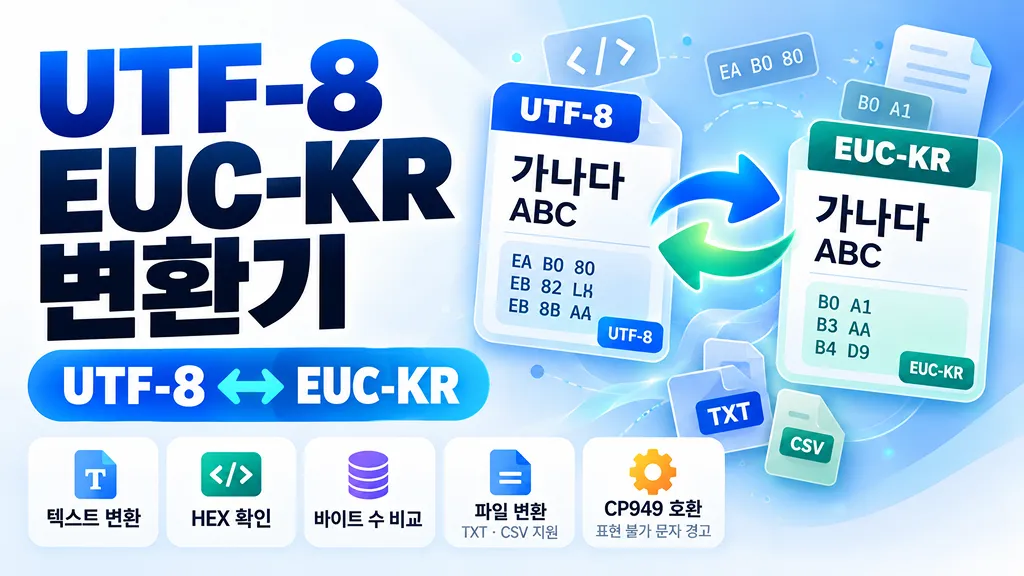
UTF-8 EUC-KR 변환기는 유니코드 기반의 UTF-8 텍스트와 한국어 레거시 문자 인코딩인 EUC-KR 계열 바이트 사이를 변환하는 도구입니다. 오래된 웹사이트, 그룹웨어, ERP, CSV 파일, 전자문서, 자막·로그 파일처럼 EUC-KR 또는 Windows-949(CP949)를 사용하는 환경에서 한글이 깨질 때 원본 바이트를 확인하거나 UTF-8로 바꿀 때 사용할 수 있습니다.
UTF-8과 EUC-KR의 차이
UTF-8은 유니코드 문자를 1~4바이트로 표현하며 현재 웹에서 가장 널리 사용하는 문자 인코딩입니다. 브라우저의
TextEncoder도 UTF-8 인코딩만 제공합니다. 반면 EUC-KR은 한국어를 위한 오래된 다중 바이트 인코딩으로 ASCII 문자는 1바이트, 한글·한자·기호는 주로 2바이트로 표현합니다.그래서 같은 한글 문자열도 UTF-8과 EUC-KR에서 바이트 값과 파일 크기가 달라집니다. 단순히 파일 확장자만 바꾸거나 문자열을 복사해 붙여넣는 것으로는 인코딩이 변환되지 않고, 실제 바이트를 대상 문자셋으로 다시 인코딩해야 합니다.
EUC-KR과 CP949가 헷갈리는 이유
한국의 오래된 Windows 프로그램에서는 CP949(Windows-949)가 많이 사용됐습니다. CP949는 EUC-KR보다 더 많은 완성형 한글을 표현할 수 있는 확장 문자셋입니다. 웹 표준의 Encoding API에서는
windows-949 같은 여러 라벨을 euc-kr 디코더로 처리합니다. 그래서 실제 서비스나 파일에서는 “EUC-KR”이라고 표시되어 있어도 CP949 확장 문자가 섞여 있는 경우가 적지 않습니다.이 도구는 기본적으로 이런 실사용 환경을 고려한 웹 호환 모드로 동작합니다. 표준 EUC-KR 바이트 범위만 확인해야 한다면 엄격 EUC-KR 검사를 켜세요. 엄격 모드에서는 ASCII 또는 A1~FE 범위의 2바이트 조합으로 표현되지 않는 문자를 경고합니다.
UTF-8 → EUC-KR 변환 방법
변환 방향을 UTF-8 → EUC-KR로 선택하고 한글 텍스트를 입력한 뒤 변환하기를 누르면 됩니다. 결과에서 UTF-8 HEX와 EUC-KR HEX를 동시에 확인할 수 있어 API 요청, 레거시 DB, 소켓 통신, 파일 헤더 분석처럼 실제 바이트 값을 비교해야 하는 개발 작업에도 활용할 수 있습니다.
EUC-KR → UTF-8 변환 방법
EUC-KR 원본 바이트를 HEX 형식으로 입력하면 UTF-8 문자열로 디코딩합니다. 공백으로 구분한
BE C8 B3 E7, 0xBE 0xC8, URL 스타일의 %BE%C8처럼 자주 쓰는 표현을 모두 입력할 수 있습니다. 파일이라면 아래 파일 변환 영역에 그대로 넣는 편이 더 정확합니다.한글이 깨지는 대표적인 이유
한글 깨짐은 대부분 실제 바이트를 다른 문자 인코딩으로 해석했을 때 발생합니다. 예를 들어, EUC-KR/CP949 바이트를 UTF-8로 읽거나, UTF-8 CSV를 오래된 프로그램이 ANSI 계열로 열면 물음표, 네모, 알 수 없는 문자 또는 의미 없는 문자열로 보일 수 있습니다.
이미 잘못 디코딩된 문자열을 다시 저장했다면 원본 바이트 정보가 손실될 수 있으므로, 가능하면 깨진 화면의 문자열보다 원본 파일이나 원본 바이트를 기준으로 변환하는 것이 안전합니다.
EUC-KR에서 이모지나 일부 한글이 변환되지 않는 이유
UTF-8은 사실상 모든 유니코드 문자를 표현할 수 있지만 EUC-KR은 표현 가능한 문자 수가 제한되어 있습니다. 이모지, 최신 기호, 일부 확장 한글은 엄격 EUC-KR에 대응되는 바이트가 없습니다. 이런 문자는 대상 시스템에서
?로 바뀌거나 저장에 실패할 수 있습니다. 변환 전에 이 도구의 표현 불가 문자 경고를 확인하세요.CSV 파일이 Excel에서 깨질 때
CSV의 한글 깨짐은 파일 자체의 인코딩과 Excel이 추정한 인코딩이 서로 다를 때 자주 발생합니다. 오래된 시스템에서 내려받은 EUC-KR/CP949 CSV라면 UTF-8로 변환한 뒤 다시 열어보고, 반대로 레거시 시스템이 UTF-8 업로드를 지원하지 않는다면 EUC-KR 형식으로 변환해 사용할 수 있습니다. 다만 시스템이 정확히 CP949를 요구하는지, 엄격 EUC-KR을 요구하는지는 별도로 확인하는 것이 좋습니다.
자주 묻는 질문
- Q. EUC-KR과 ANSI는 같은 인코딩인가요?A. 아닙니다. ANSI는 하나의 고정된 문자셋 이름이라기보다 Windows 코드페이지를 뭉뚱그려 부르는 경우가 많습니다. 한국어 Windows 환경에서는 CP949가 ANSI로 표시되는 경우가 흔합니다.
- Q. EUC-KR 파일에 BOM을 붙여야 하나요?A. 일반적으로 EUC-KR은 UTF-8 BOM처럼 BOM을 사용하지 않습니다. 대상 프로그램이 요구하는 인코딩과 파일 형식을 확인하세요.
- Q. 웹 브라우저에서 EUC-KR 인코딩이 가능한가요?A. 기본
TextEncoder는 UTF-8만 지원합니다. 이 페이지는 프로젝트에 포함된iconv-lite를 이용해 EUC-KR/CP949 바이트를 생성합니다. - Q. 개인정보가 포함된 파일을 올려도 되나요?A. 이 페이지의 변환 로직은 브라우저에서 실행되도록 구성되어 있으며 업로드한 텍스트 파일을 별도 변환 서버로 전송하지 않습니다. 다만 실제 배포 환경에서 추가 로그나 분석 스크립트를 사용하는 경우 운영 정책도 함께 확인하는 것이 좋습니다.