선형회귀 계산기란?
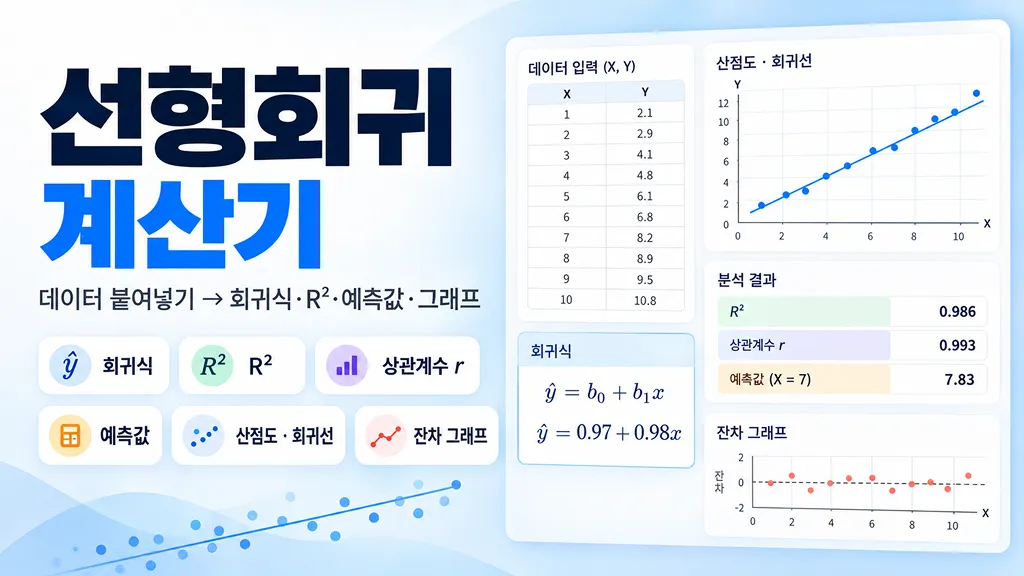
선형회귀 계산기는 두 변수 X와 Y의 데이터를 이용해 두 변수 사이의 관계를 하나의 직선으로 표현하는 도구입니다. 엑셀이나 구글 스프레드시트에서 두 열을 그대로 붙여넣으면 회귀식, 기울기, 절편, 결정계수 R², 상관계수, p값, 신뢰구간, 예측값을 한 번에 계산할 수 있습니다.
예를 들어, 광고비(X)와 매출(Y), 공부시간(X)과 시험점수(Y), 온도(X)와 판매량(Y)처럼 한 값이 변할 때 다른 값이 어떤 방향과 크기로 움직이는지 간단히 확인할 때 사용할 수 있습니다.
선형회귀 계산기 사용 방법
한 줄에 X와 Y 두 값을 입력합니다. 탭, 쉼표, 세미콜론, 공백을 구분자로 사용할 수 있으며 스프레드시트의 두 열을 복사해 그대로 붙여넣는 방식이 가장 간단합니다.
광고비 매출10 8220 10130 119첫 행에
광고비, 매출 같은 제목이 있으면 그래프 축과 표 머리글에 그대로 사용됩니다. 열이 3개 이상이면 X 열과 Y 열을 직접 고를 수 있습니다. 계산 후에는 회귀식을 텍스트·LaTeX·엑셀 수식으로 복사하고, 데이터별 예측값과 잔차를 CSV로 내려받을 수 있습니다.선형회귀식의 의미
단순 선형회귀의 기본 형태는 다음과 같습니다.
여기서 는 예측한 Y 값, 는 절편, 은 기울기입니다. 기울기가 2라면 X가 1 증가할 때 예측 Y가 평균적으로 약 2 증가합니다.
이 계산기는 가장 널리 쓰이는 최소제곱법(least squares)을 사용합니다. 각 관측값과 회귀선 사이의 오차인 잔차를 제곱한 값들의 합이 가장 작아지는 기울기와 절편을 찾는 방식입니다.
선형회귀 계산식
기울기는 X와 Y가 각자의 평균에서 함께 움직이는 정도를 X의 변동으로 나누어 계산합니다.
R²(결정계수)는 어떻게 해석하나요?
R²는 회귀모형이 Y의 변동을 어느 정도 설명하는지 나타내는 값입니다. 예를 들어, R²가 0.80이라면 현재 데이터에서 Y 변동의 약 80%가 이 선형모형으로 설명된다는 뜻입니다.
다만 R²가 높다고 해서 반드시 좋은 예측모형이라는 뜻은 아닙니다. 곡선 관계가 있거나 이상치가 결과를 크게 끌어당기는 경우에도 R²만 보면 문제를 놓칠 수 있어 산점도와 잔차 그래프를 함께 확인하는 것이 중요합니다.
조정 R²는 데이터 수에 비해 모형이 지나치게 맞춰지는 것을 보정한 값으로, 데이터가 적을수록 R²보다 조금 더 낮게 나옵니다.
선형회귀의 역사와 유래
선형회귀(Linear Regression)는 수학과 통계학에서 오랜 역사를 가진 분석 방법입니다. 오늘날에는 매출 예측, 데이터 분석, 머신러닝 등에 활용되지만, 처음에는 천체의 위치와 움직임을 더 정확하게 계산하려는 연구에서 중요한 발전이 이루어졌습니다.
1805년 — 르장드르와 최소제곱법의 등장
프랑스 수학자 아드리앵마리 르장드르(Adrien-Marie Legendre)는 1805년 천체 궤도 계산에 관한 저서에서 최소제곱법(Method of Least Squares)을 발표했습니다.
천체를 여러 번 관측하면 측정 오차 때문에 결과가 조금씩 달라집니다. 르장드르는 관측값과 계산값의 차이를 제곱한 뒤 모두 더한 값이 최소가 되도록 모형의 계수를 결정하는 방법을 제시했습니다. 이 원리는 현재 선형회귀 계산기의 핵심 계산 방법으로 사용됩니다.
1809년 — 가우스와 최소제곱법의 발전
독일 수학자 카를 프리드리히 가우스(Carl Friedrich Gauss)도 천체 궤도와 관측 오차를 연구하며 최소제곱법을 발전시켰습니다. 가우스는 자신이 1795년부터 이 방법을 사용했다고 주장했지만, 공개된 연구로는 르장드르의 1805년 발표가 앞섭니다.
가우스는 1809년 저서에서 관측 오차의 확률분포와 최소제곱법의 관계를 설명했습니다. 이후 이 방법은 천문학과 측량학에서 널리 활용되었고, 통계적 추정과 회귀분석의 발전에 중요한 기반이 되었습니다.
1880년대 — 골턴과 회귀분석이라는 이름
회귀(Regression)라는 이름은 영국의 과학자 프랜시스 골턴(Francis Galton)의 연구와 관련이 있습니다. 골턴은 1880년대 부모와 자녀의 키 사이의 관계를 연구하면서 평균으로의 회귀(Regression Toward the Mean)라는 현상을 설명했습니다.
부모의 키가 평균보다 매우 크더라도 자녀의 키는 통계적으로 부모만큼 극단적이지 않고 집단 평균에 가까워지는 경향이 나타났습니다. 반대로 키가 작은 부모의 자녀도 평균에 조금 더 가까워지는 경향을 관찰했습니다.
여기에서 사용된 회귀라는 표현이 발전하면서, 오늘날 변수 사이의 관계를 수학적으로 추정하는 회귀분석(Regression Analysis)이라는 용어로 자리 잡았습니다. 다만 현대 회귀분석이 반드시 평균으로의 회귀 현상만을 분석하는 것은 아닙니다.
1890년대 이후 — 피어슨과 현대 통계학
통계학자 칼 피어슨(Karl Pearson)은 1890년대에 변수 사이의 선형 관계를 측정하는 상관계수를 체계화했습니다. 오늘날 사용하는 피어슨 상관계수(Pearson Correlation Coefficient)가 여기에 해당합니다.
이후 20세기에는 회귀계수의 통계적 추론, 가설검정, 신뢰구간 및 분산분석이 발전하면서 회귀분석이 과학 연구와 경제학의 주요 분석 방법으로 자리 잡았습니다. 현재는 통계 소프트웨어뿐 아니라 머신러닝의 기본적인 예측 모형으로도 사용되고 있습니다.
참고로 최소제곱법과 회귀분석은 완전히 같은 개념은 아닙니다. 최소제곱법은 모형의 계수를 추정하는 방법이고, 회귀분석은 변수 사이의 관계를 설명하거나 예측하기 위한 더 넓은 통계적 분석 방법입니다.
상관계수 r과 R²의 차이
상관계수 r은 두 변수의 선형 관계의 방향과 강도를 -1부터 1 사이의 값으로 나타냅니다. 양수이면 X가 증가할수록 Y도 증가하는 방향, 음수이면 X가 증가할수록 Y가 감소하는 방향입니다. 절편이 있는 단순 선형회귀에서는 관계가 성립합니다.
p값과 신뢰구간 해석
기울기의 표준오차는 데이터가 회귀선 주위에 얼마나 흩어져 있는지(잔차 표준오차 )와 X가 얼마나 넓게 퍼져 있는지로 결정됩니다.
t값을 자유도 n-2인 t분포와 비교해 p값을 구합니다. p값이 0.05보다 작고 95% 신뢰구간에 0이 포함되지 않으면 유의수준 5%에서 기울기가 0이 아니라고 판단합니다. 단순 선형회귀에서는 기울기의 t검정과 모형 전체의 F검정 결과가 같습니다().
신뢰구간 vs 예측구간
특정 X 값 에서의 예측에는 두 가지 구간이 있습니다. 신뢰구간은 그 X에서 Y의 평균이 있을 범위, 예측구간은 새로 관측할 Y 하나가 들어올 범위입니다.
두 구간 모두 가 평균 에서 멀어질수록 넓어집니다. 그래프의 파란 음영(95% 신뢰대)이 양 끝으로 갈수록 벌어지는 이유입니다.
잔차 그래프를 함께 봐야 하는 이유
잔차(residual)는 실제 Y 값에서 회귀식이 예측한 Y 값을 뺀 값입니다. 잔차 그래프에서 점들이 0을 중심으로 무작위에 가깝게 흩어져 있다면 직선 모형이 비교적 자연스럽게 맞는다고 볼 수 있습니다.
반대로 잔차가 U자형이나 곡선 패턴을 보이거나 X가 커질수록 잔차 폭이 계속 커진다면, 단순 선형회귀보다 다른 모형이나 변수 변환이 더 적절한지 검토할 필요가 있습니다. 이 계산기의 큰 잔차 표시는 표준화 잔차의 절댓값이 2 이상인 데이터로, 삭제 대상이 아니라 입력 오류나 특이 사례를 다시 확인하기 위한 참고 표시입니다.
예측값을 사용할 때 주의할 점
원래 관측한 X 범위를 벗어나는 예측은 외삽(extrapolation)입니다. 데이터가 없던 범위에서도 같은 직선 관계가 계속된다는 보장이 없기 때문에 범위 안의 예측보다 불확실성이 커집니다. 그래프에서는 관측 범위 밖의 회귀선을 점선으로 표시합니다.
선형회귀 관련 용어 정리
선형회귀 분석 결과에는 기울기와 절편 외에도 R², p값, 표준오차, 잔차 등 다양한 통계 용어가 등장합니다. 각 용어의 의미를 이해하면 단순히 회귀식을 구하는 것을 넘어 분석 결과가 얼마나 신뢰할 만한지 판단하는 데 도움이 됩니다.
독립변수(X)와 종속변수(Y)
독립변수(Independent Variable)는 다른 값을 설명하거나 예측하기 위해 사용하는 변수입니다. 설명변수(Explanatory Variable), 예측변수(Predictor)라고도 합니다.
종속변수(Dependent Variable)는 독립변수를 이용해 설명하거나 예측하려는 값입니다. 반응변수(Response Variable), 결과변수라고도 부릅니다.
예를 들어, 광고비에 따른 매출을 분석한다면 광고비가 X, 매출이 Y입니다. 다만 독립변수와 종속변수라는 이름이 두 변수 사이의 인과관계를 자동으로 의미하지는 않습니다.
회귀계수(Regression Coefficient)
회귀계수는 회귀식에서 변수 사이의 관계를 나타내는 숫자입니다. 단순 선형회귀에서는 기울기와 절편이 회귀계수에 해당합니다.
기울기(Slope)는 X가 1단위 증가할 때 예측 Y가 얼마나 변하는지를 나타냅니다. 양수이면 증가하는 방향, 음수이면 감소하는 방향입니다.
절편(Intercept)은 X가 0일 때의 예측 Y입니다. 다만 데이터에 X=0이 없거나 현실적으로 의미 없는 값이라면 절편을 실제 관측값처럼 해석하지 않도록 주의해야 합니다.
적합값(Fitted Value)과 잔차(Residual)
적합값은 실제 데이터의 X를 회귀식에 넣어 계산한 예측 Y 값입니다. 일반적으로 로 표시합니다.
잔차는 실제 Y에서 적합값을 뺀 차이입니다. 예를 들어, 실제 매출이 120이고 회귀식의 예측 매출이 115라면 잔차는 +5입니다.
잔차가 양수이면 실제값이 예측보다 크고, 음수이면 실제값이 예측보다 작습니다. 잔차 분석을 통해 회귀선이 데이터에 적절하게 맞는지 확인할 수 있습니다.
OLS(Ordinary Least Squares, 보통최소제곱법)
OLS는 잔차를 제곱한 값들의 합이 최소가 되도록 회귀계수를 추정하는 방법입니다. 가장 기본적인 선형회귀 분석에 널리 사용됩니다.
잔차를 제곱하기 때문에 양수와 음수의 오차가 서로 상쇄되지 않으며, 큰 오차에 더 높은 비중이 부여됩니다. 따라서 극단적인 관측값의 영향을 크게 받을 수 있습니다.
SSE, MSE, RMSE, MAE란?
이 지표들은 회귀모형의 예측값과 실제값 사이의 오차를 서로 다른 방식으로 측정합니다.
- SSE(잔차제곱합): 모든 잔차를 제곱해 더한 값입니다. 작을수록 해당 데이터에 대한 오차제곱합이 작습니다.
- MSE(평균제곱오차): 잔차제곱합을 관측값 개수로 나눈 값입니다. 오차를 제곱하므로 큰 오차의 영향이 큽니다.
- RMSE(평균제곱근오차): MSE의 제곱근입니다. Y와 단위가 같아 오차 크기를 직관적으로 이해하기 좋습니다.
- MAE(평균절대오차): 잔차의 절댓값을 평균한 값입니다. 예측값이 실제값과 평균적으로 얼마나 차이 나는지 파악할 때 사용합니다.
예를 들어, 시험점수를 예측하는 모형에서 RMSE가 5라면 제곱평균 기준 오차 크기가 약 5점이라는 의미입니다. 모든 예측이 반드시 5점 이내라는 뜻은 아닙니다.
잔차 표준오차(Residual Standard Error, RSE)는 회귀계수를 추정하면서 사용한 자유도를 반영한 오차 지표입니다. 절편과 기울기를 추정하는 단순 선형회귀에서는 잔차제곱합을 n-2로 나눈 값의 제곱근을 사용합니다.
통계적 추론에서 사용하는 잔차분산 추정량은 SSE/(n-2)이며, 예측 오차 평가에 사용하는 MSE=SSE/n과 구분해야 합니다. 둘은 계산 목적과 분모가 다릅니다.
표준오차(Standard Error, SE)
표준오차는 표본으로 추정한 통계량이 표본을 다시 추출할 때 얼마나 달라질 수 있는지를 나타내는 지표입니다.
선형회귀에서는 특히 기울기의 표준오차를 이용해 기울기의 신뢰구간을 구하고, 기울기가 0과 통계적으로 구별되는지 검정합니다. 일반적으로 다른 조건이 같다면 표준오차가 작을수록 회귀계수를 더 정밀하게 추정한 것으로 해석할 수 있습니다.
표준편차와 표준오차의 차이
표준편차(Standard Deviation, SD)는 개별 데이터가 평균을 중심으로 얼마나 흩어져 있는지 나타냅니다.
반면 표준오차는 개별 데이터의 흩어짐이 아니라 표본으로 계산한 추정값의 불확실성을 나타냅니다. 두 용어 모두 데이터의 변동성과 관련이 있지만 측정하는 대상은 서로 다릅니다.
자유도(Degrees of Freedom, df)
자유도는 통계량을 계산할 때 독립적으로 변할 수 있는 정보의 수와 관련된 개념입니다.
단순 선형회귀에서는 관측값이 n개이고 기울기와 절편이라는 2개의 계수를 추정하므로 잔차의 자유도가
n - 2입니다. 관측값이 20개라면 잔차 자유도는 18입니다. 자유도는 t검정, F검정, 신뢰구간 계산에 사용됩니다.t값(t-statistic)과 p값(p-value)
t값은 추정된 기울기가 귀무가설에서 가정하는 값(일반적으로 0)으로부터 표준오차의 몇 배만큼 떨어져 있는지 나타냅니다.
p값은 기울기가 0이라는 귀무가설이 참이고 검정의 가정이 성립한다고 할 때, 관측된 결과만큼 또는 그보다 극단적인 검정통계량이 나타날 확률입니다.
일반적으로 p값이 0.05보다 작으면 유의수준 5%에서 기울기가 0이라는 귀무가설을 기각합니다. 하지만 p값이 작다고 해서 관계가 강하거나 실제로 중요한 효과라는 뜻은 아닙니다.또한 p값은 귀무가설이 참일 확률이 아닙니다.
신뢰수준(Confidence Level)과 유의수준(α)
신뢰수준은 신뢰구간을 반복적으로 계산했을 때 구간이 실제 모수를 포함하는 장기적인 비율을 나타냅니다. 95% 신뢰수준은 이러한 절차를 반복하면 약 95%의 구간이 실제 모수를 포함하도록 설계됐다는 뜻입니다.
유의수준(Significance Level)은 참인 귀무가설을 잘못 기각할 위험을 관리하기 위해 미리 정하는 기준입니다. 95% 양측 신뢰구간은 일반적으로 유의수준 5%의 양측 검정과 대응합니다.
이상치(Outlier)와 영향력이 큰 데이터
이상치는 다른 관측값과 비교해 눈에 띄게 다른 값을 의미합니다. 특히 실제 Y가 회귀선에서 크게 벗어난 경우 잔차가 크게 나타납니다.
다만 잔차가 크다고 해서 반드시 잘못된 데이터는 아닙니다. 측정 오류일 수도 있지만 실제로 발생한 중요한 사례일 수도 있습니다.
레버리지(Leverage)는 관측값의 X가 다른 X 값들과 비교해 얼마나 멀리 떨어져 있는지를 나타내는 개념입니다. 레버리지가 큰 데이터는 회귀선의 위치나 기울기에 큰 영향을 줄 수 있습니다.
영향점(Influential Observation)은 해당 관측값을 제거했을 때 회귀계수가 눈에 띄게 달라지는 데이터입니다. 실제 영향력을 정량적으로 평가할 때는 쿡의 거리(Cook's Distance) 등을 사용합니다. 큰 잔차, 높은 레버리지, 큰 영향력은 서로 다른 개념입니다.
정규성·등분산성·독립성
선형회귀에서 통계적 추론을 수행할 때는 오차에 대한 몇 가지 가정을 검토해야 합니다.
- 선형성(Linearity): X와 Y의 조건부 평균 관계가 회귀식의 직선 형태로 적절하게 표현되는지 확인합니다.
- 독립성(Independence): 오차들이 서로 독립적인지 확인합니다. 특히 시간 순서가 있는 데이터에서는 자기상관에 주의해야 합니다.
- 등분산성(Homoscedasticity): X 값에 따라 오차의 분산이 크게 달라지지 않는다는 가정입니다. 잔차 그래프에서 퍼짐이 한쪽으로 커지는지 확인할 수 있습니다.
- 정규성(Normality): 통상적인 소표본 t검정과 신뢰구간에 사용되는 오차의 정규분포 가정입니다. 원래 X나 Y 자체가 반드시 정규분포를 따라야 한다는 의미는 아닙니다.
최소제곱법으로 회귀계수를 계산하는 것 자체에 오차의 정규성 가정이 반드시 필요한 것은 아닙니다. 다만 p값과 신뢰구간을 해석할 때는 사용한 통계적 가정이 적절한지 확인해야 합니다.
과적합(Overfitting)과 외삽(Extrapolation)
과적합은 모형이 기존 데이터의 우연한 패턴이나 잡음까지 지나치게 학습해 새로운 데이터에서 예측 성능이 낮아지는 현상입니다.
외삽은 관측한 X의 최솟값과 최댓값을 벗어나 Y를 예측하는 것입니다. 단순 선형회귀에서는 X가 0부터 100까지 관측되었는데 X=200을 예측하는 경우가 외삽에 해당합니다. 관측 범위 밖에서도 동일한 관계가 유지된다고 보장할 수 없으므로 주의가 필요합니다.
활용 예시
- 마케팅: 광고비와 매출·전환수의 관계 확인
- 학습: 공부시간과 점수의 선형 관계 확인
- 업무·KPI: 활동량과 성과지표의 추세 분석
- 실험 데이터: 측정값 두 변수의 직선 적합과 검량선 작성
- 간단한 예측: 관측 범위 안의 X 값으로 예상 Y와 예측구간 계산
자주 묻는 질문
- Q. 데이터는 몇 개가 필요한가요?A. 회귀식은 서로 다른 X 값 2개만 있어도 계산되지만, 두 점은 항상 직선 위에 있어 R²가 1이 되고 표준오차·p값·신뢰구간을 구할 수 없습니다. 통계적 추론에는 최소 3개, 실제 분석에서는 그보다 훨씬 많은 관측값을 사용하는 것이 좋습니다.
- Q. X와 Y 중 무엇이 독립변수인가요?A. 기본적으로 첫 번째 열을 X(설명변수·독립변수), 두 번째 열을 Y(반응변수·종속변수)로 사용합니다. 열이 3개 이상이면 X 열과 Y 열을 직접 선택할 수 있으며, 회귀식은 X로 Y를 예측하는 방향으로 계산됩니다.
- Q. 기울기의 p값은 무엇을 뜻하나요?A. 실제 기울기가 0(관계 없음)이라고 가정했을 때 지금처럼 크거나 더 극단적인 기울기가 우연히 관측될 확률입니다. 흔히 0.05보다 작으면 기울기가 0이 아니라는 근거가 있다고 봅니다. 다만 p값은 관계의 크기나 실무적 중요성을 말해주지 않습니다.
- Q. 신뢰구간과 예측구간은 어떻게 다른가요?A. 신뢰구간은 해당 X에서 Y의 평균값이 있을 범위이고, 예측구간은 새로 관측할 Y 하나가 들어올 범위입니다. 개별 값은 평균보다 흩어짐이 크기 때문에 예측구간이 항상 더 넓습니다.
- Q. 상관관계가 높으면 인과관계가 증명되나요?A. 아닙니다. 선형회귀와 상관계수는 두 변수가 함께 움직이는 패턴을 보여줄 뿐 원인과 결과를 증명하지 않습니다. 실험 설계, 다른 영향 변수, 시간 순서 같은 추가 근거가 필요합니다.
- Q. 왜 X 값이 모두 같으면 계산이 안 되나요?A. 기울기는 X가 변할 때 Y가 얼마나 변하는지를 나타내므로 X에 변화가 있어야 합니다. 모든 X가 같으면 X의 변동이 0이어서 기울기를 하나로 정할 수 없습니다.
- Q. 천 단위 쉼표가 있는 숫자도 입력할 수 있나요?A. 네, 엑셀에서 복사한 탭 구분 데이터의 1,000 같은 값은 천 단위 구분자로 인식합니다. 세미콜론으로 구분한 데이터에서는 1,5처럼 쉼표를 소수점으로 읽습니다.
참고 자료
계산 원리와 설명은 NIST Engineering Statistics Handbook과 Penn State STAT 강의 자료를 참고했습니다.